Lo que ve un detector en el vídeo de la portada
Josep Castells · · 3 min de lectura
Qué parte del vídeo de la portada es un modelo de verdad, qué parte está precalculada y qué parte es un ejemplo.
El vídeo de la portada no es una animación: debajo de las capas de interfaz hay un modelo de detección de objetos que analizó cada plano. Aquí cuento cómo está hecho, qué parte es real y qué parte es un ejemplo.
Seis planos, diecinueve segundos y medio
El vídeo es un montaje de seis planos de Pexels, con cortes secos: un cruce de tráfico, una cosechadora, un puerto, una cocina, unos aerogeneradores y una ecocardiografía. Tres de ellos son los sectores de los bloques que aparecen al hacer scroll (campo, cocina y salud); los otros tres dan contexto. Pexels permite el uso comercial sin atribución obligatoria, pero los clips están acreditados igualmente.
Qué hace el detector, y cuándo
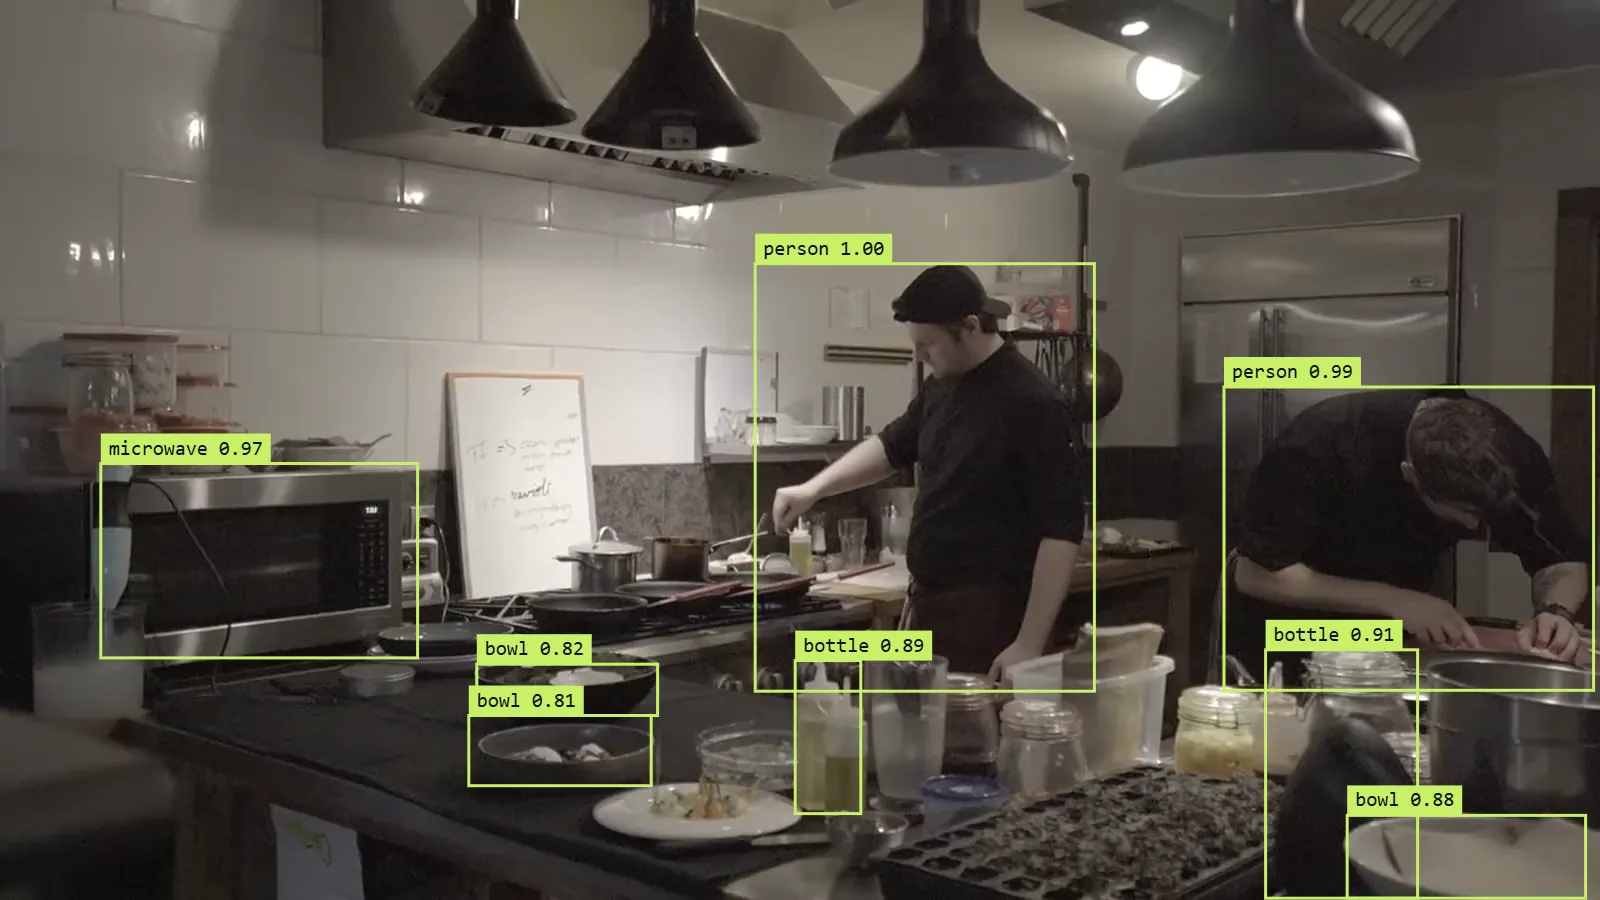
El modelo es un Faster R-CNN con MobileNetV3 de torchvision, entrenado con COCO, que distingue ochenta tipos de objeto. No se ejecuta en tu navegador: lo pasé una sola vez sobre el montaje, a cinco fotogramas por segundo, y guardé las cajas en un archivo de 4 KB que la página dibuja encima del vídeo.
En la cocina, por ejemplo, encuentra a las dos personas con una confianza de 1,00 y 0,99, el microondas, las botellas y los cuencos sobre la encimera. Son las cajas de la imagen de arriba, tal como las devolvió el modelo.
Antes de publicarlas apliqué tres filtros:
- Confianza mínima de 0,7 y como mucho ocho cajas por fotograma, para que la imagen se lea.
- Clases imposibles fuera. Un avión, unos esquís o un plátano no pueden aparecer en estos planos; si el modelo los ve, es un error, y un error en la portada parece un fallo de la web.
- Ninguna caja en la ecocardiografía. COCO no sabe nada de anatomía: en ese plano lo único que encontraba era el teclado. Mejor no enseñar nada que enseñar algo irrelevante.
Lo que el modelo ve mal
El plano aéreo del cruce es el más difícil. COCO está hecho de fotos tomadas a pie de calle; desde un dron, un coche o una persona tienen otra forma, y el modelo duda. En algún fotograma llega a marcar como persona un trozo de patio. Es un buen recordatorio de algo que repito en cualquier proyecto: un modelo es tan bueno como el parecido entre sus datos de entrenamiento y lo que le enseñas después.
Lo que se calcula en tu navegador
Las curvas de nivel que se mueven sobre la imagen sí se calculan en directo: la página lee el brillo del vídeo en una rejilla de 96 por 54 puntos y traza cuatro niveles con el algoritmo de marching squares. Es barato, no necesita ningún modelo y funciona en cualquier equipo.
Las capas de interfaz que flotan delante (un índice de vegetación en el campo, una fracción de eyección en salud…) son ejemplos de cómo se vería un sistema así en cada sector, y en la página llevan la etiqueta «Ejemplo». Lo único que sale de un modelo de verdad son las cajas.
Cómo se sirve
Un vídeo de seis megas no debería frenar una portada:
- Sin reproducción automática ni precarga. Si tienes activado el ahorro de datos o prefieres menos movimiento, solo ves una imagen fija.
- Dos tamaños. En el móvil se descarga una versión de 1280×720 de menos de 2 MB; el navegador solo baja una de las dos.
- Fuera del repositorio. Los vídeos se publican aparte con un nombre que cambia con su contenido, así que se pueden guardar en caché para siempre sin miedo a servir una versión vieja.
Por qué lo cuento
Porque es la misma pregunta que hay que hacerse ante cualquier demo de IA: qué parte es un modelo, qué parte está precalculada y qué parte es diseño. En el Laboratorio puedes probar un detector parecido con tu propia cámara, y ahí todo se ejecuta en directo.