Datos y modelos que se pueden usar en una web comercial
Josep Castells · · 3 min de lectura
Por qué el Laboratorio no usa YOLO ni ImageNet, qué licencias sí acepta y cómo se cumple la atribución de CC BY.
Un modelo puede ser excelente y aun así no poder usarse en una web comercial. Antes de mirar la precisión de un modelo para el Laboratorio miro dos cosas: la licencia del código y del modelo, y la de los datos con los que se entrenó. Aquí va lo que descarté, lo que acepté y por qué.
Lo que se quedó fuera
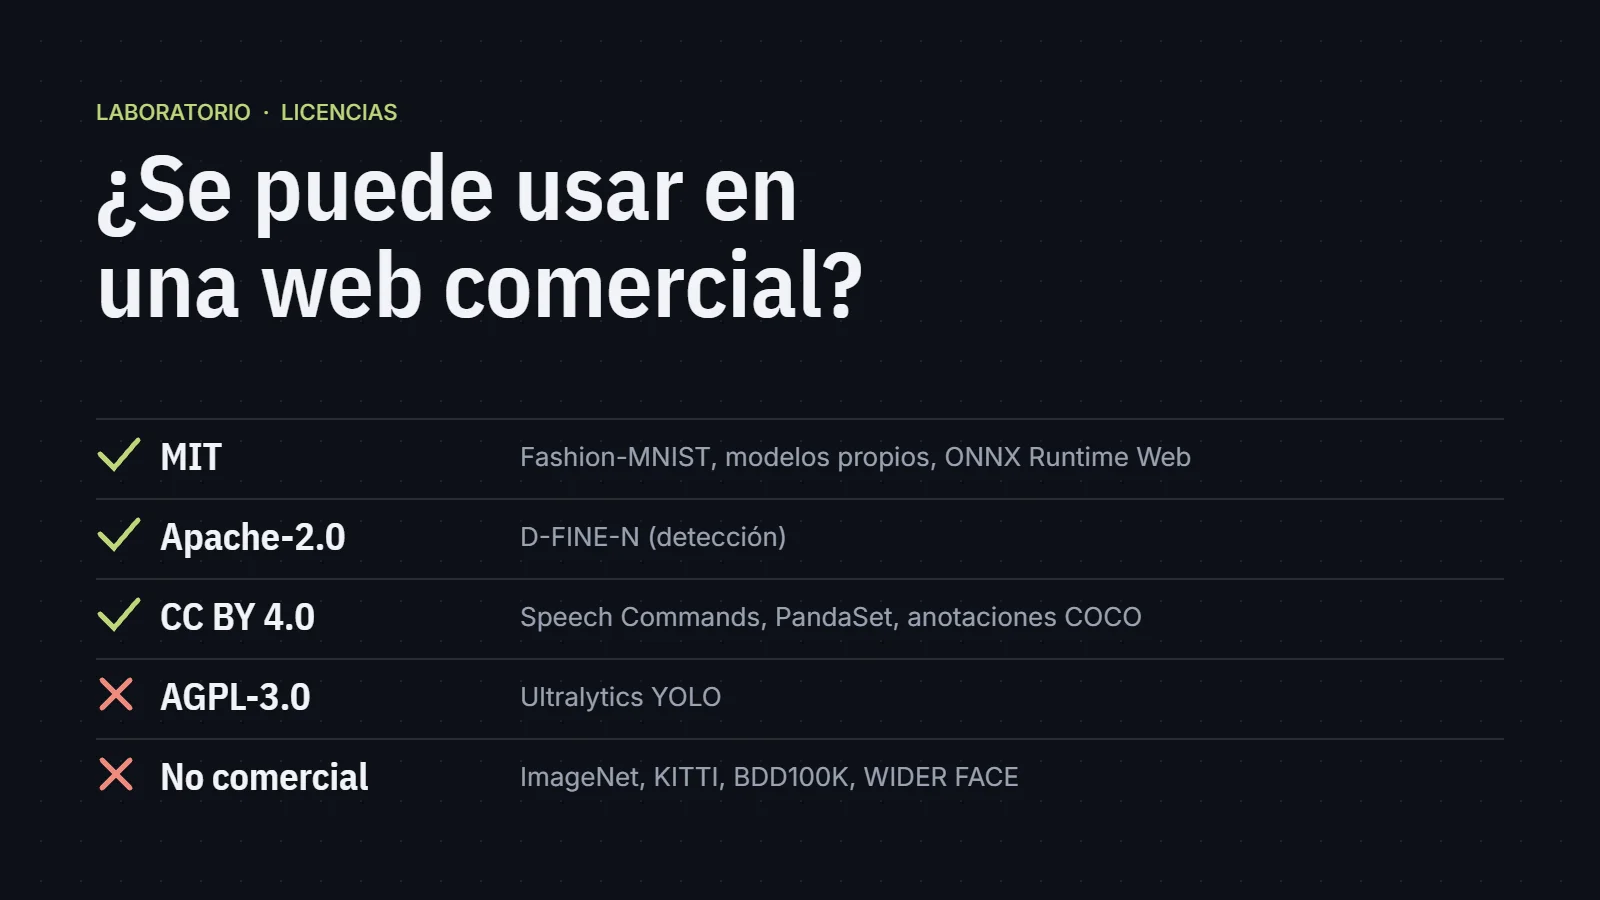
Ultralytics YOLO (AGPL-3.0). Es la familia de detectores más conocida y la primera que aparece en cualquier tutorial. Su licencia es AGPL: si la usas en un servicio accesible por red, tienes que publicar el código de ese servicio con la misma licencia. Para una web comercial eso significa abrir la web entera o pagar una licencia comercial. En su lugar uso D-FINE-N, con licencia Apache 2.0.
Conjuntos de datos solo para investigación. ImageNet, KITTI, BDD100K y WIDER FACE son referencias en sus campos, pero sus términos limitan el uso a fines no comerciales. Un modelo entrenado con ellos arrastra esa duda, así que no entraron.
Comprobar el modelo concreto, no la familia. Que una arquitectura sea abierta no dice nada del archivo de pesos que descargas: cada checkpoint puede tener su propia licencia, y algunos se ajustaron con datos no comerciales. Miro el campo de licencia del modelo exacto que voy a publicar.
Lo que sí se usa
- MIT: Fashion-MNIST (© 2017 Zalando SE), los modelos que he entrenado yo, ONNX Runtime Web y three.js.
- Apache 2.0: D-FINE-N, el detector de la demo de detección.
- CC BY 4.0: Speech Commands (Pete Warden, Google), las anotaciones de COCO y PandaSet, este último con sus propios términos además de la licencia.
- CC BY 4.0 con clips CC0 o CC BY 3.0: FSDnoisy18k, que solo uso como ruido de fondo para entrenar el modelo de voz.
- Anotaciones CC BY 4.0, imágenes CC BY 2.0: Open Images, para el detector de ingredientes. Guardo el autor y la licencia de cada imagen.
Atribución: lo que pide CC BY
CC BY permite el uso comercial con una condición: reconocer la autoría. Por eso el Laboratorio tiene una página de créditos que se construye sola a partir de las fichas de los modelos: si añado un conjunto de datos, su atribución aparece sin que tenga que acordarme.
Dos matices que conviene saber:
- Las imágenes no siempre tienen la licencia de las anotaciones. En COCO, las anotaciones son CC BY 4.0, pero las fotos siguen los términos de Flickr. Se puede entrenar con ellas; lo que no hago es redistribuirlas.
- Las licencias no anonimizan. PandaSet no viene anonimizado. Antes de publicar sus imágenes desenfoqué caras y matrículas, y sus términos además prohíben usar las marcas de quienes lo publicaron.
La regla, en corto
- Licencia del código y del modelo: permisiva (MIT, Apache 2.0, BSD). Nada de copyleft fuerte en un servicio web.
- Licencia de los datos: que permita uso comercial. «Solo investigación» queda fuera.
- Cada archivo concreto, no la familia ni el nombre.
- Atribución automática, no de memoria.
- Lo que no se pueda redistribuir, no se redistribuye, aunque se pueda entrenar con ello.
Por qué importa fuera del Laboratorio
La misma pregunta aparece en cualquier proyecto de IA para una empresa: ¿qué modelo, con qué datos y bajo qué condiciones? Un asistente que funciona de maravilla en una demo puede no ser utilizable en producción por una licencia. Lo reviso al principio, en el diagnóstico, para que no aparezca al final.